Quanti coperti sabato?
Ogni ristoratore se lo chiede il giovedì: quanti coperti farò sabato sera? Dalla risposta dipendono quanta carne ordinare, quanti camerieri chiamare, se aprire la sala sopra.
Quasi sempre la risposta è a occhio: "come sabato scorso", oppure "più o meno la media degli ultimi sabati". Funziona abbastanza, ed è proprio per questo che è difficile da battere.
Da poco Mistral ha rilasciato Timestral, una famiglia di foundation model per serie temporali. La promessa è la stessa degli LLM, ma per i numeri: gli dai lo storico, lui ti restituisce la previsione, senza addestrare niente. Ho voluto vedere se regge su un problema concreto e un po' sporco come i coperti di un ristorante.
Spoiler: funziona, ma non sempre, e il caso in cui sbaglia è il più istruttivo.
Cos'è Timestral, in breve
Un foundation model per serie temporali è un modello già addestrato su moltissime serie diverse (vendite, traffico, energia, meteo…). Non sa niente del tuo ristorante, ma ha visto abbastanza andamenti da riconoscere stagionalità, tendenze e ritmi settimanali in una serie che non ha mai incontrato. Si chiama previsione zero-shot.
Le caratteristiche di Timestral che contano qui:
- Quattro taglie: 5M, 28M, 123M e 209M parametri. Il più piccolo gira tranquillamente su CPU.
- Previsioni probabilistiche: non restituisce un numero solo, ma 21 quantili. Quindi non solo "farai 120 coperti", ma anche "con l'80% di probabilità tra 100 e 140".
- Covariate: puoi passargli informazioni aggiuntive, sia note solo nel passato (per esempio la pioggia dei giorni scorsi) sia note anche nel futuro (giorno della settimana, festivi, chiusure).
- Fino a 32.768 punti di storico in ingresso e fino a 1.024 punti previsti in una sola passata.
- Licenza Modified MIT, utilizzabile on-premise: i dati del ristorante non devono andare da nessuna parte.
L'esperimento
I dati (simulati, e lo dico subito)
Non ho dati reali di un ristorante da pubblicare, quindi ho simulato lo storico di una trattoria romana. Non è il massimo, ma ha un vantaggio: so esattamente quali regole ci sono dentro, e posso dire se il modello le ha capite.
Lo storico va da gennaio 2024 a ottobre 2026, un valore al giorno, con queste regole:
- circa 70 coperti di base, con una crescita dell'8% l'anno;
- chiuso il lunedì; venerdì ×1,45, sabato ×1,7, domenica ×1,25;
- agosto al 55%, perché Roma si svuota; dicembre ×1,2;
- festivi italiani ×1,35 (Pasqua compresa), aperto anche se cadono di lunedì; chiuso dal 24 al 26 dicembre e il 1° gennaio;
- pioggia in circa un giorno su quattro, ×0,85;
- un rumore casuale di circa l'8%.
In media, nei giorni di apertura, sono circa 88 coperti.
Le domande
Ho confrontato Timestral con le due regole che usa un ristoratore:
- "Come la settimana scorsa": lo stesso giorno della settimana precedente.
- "Media degli ultimi 4": la media degli ultimi 4 giorni uguali (gli ultimi 4 sabati, ecc.).
Tutti i metodi sanno quando il locale è chiuso, perché un ristoratore lo sa, e l'errore è misurato solo sui giorni di apertura. Ho provato due finestre:
- Ottobre 2026: 4 settimane normali.
- 20 luglio – 31 agosto 2025: il caso difficile, con il crollo di agosto e Ferragosto in mezzo.
Per ognuna, Timestral 5M e 28M in tutte le prove, più 123M e 209M sulle prove con tutto lo storico, con e senza il calendario (giorno della settimana, festivi, chiusure come covariate note, pioggia come covariata passata), e con due quantità di storico: tutto quello disponibile, oppure solo le ultime 8 settimane, come un locale appena aperto.
Per non farmi ingannare da un caso fortunato, ho rigenerato i dati 5 volte con semi diversi: i numeri qui sotto sono medie.
Il codice
L'installazione è da GitHub, e l'uso è sorprendentemente breve:
pip install git+https://github.com/mistralai/timestral.git
import numpy as np
from timestral import TimestralForecaster

model = TimestralForecaster.from_pretrained("mistralai/Timestral-28M")  # device="cuda" per la GPU

# coperti giornalieri: forma (serie, variabili, tempo)
context = covers.astype(np.float32)[None, None, :]

forecast = model.forecast(
    context,
    prediction_length=28,
    known_covariates=holiday_and_closed,      # (1, 2, storico + 28): festivi e chiusure
    categorical_known_covariates=weekday,     # (1, 1, storico + 28): giorno della settimana
    past_covariates=rain,                     # (1, 1, storico): pioggia, nota solo nel passato
)

forecast.median          # la previsione "centrale"
forecast.quantile(0.1)   # limite basso dell'intervallo all'80%
forecast.quantile(0.9)   # limite alto
Tutto gira su un portatile, solo con la CPU.
Risultato 1: in un mese normale, vince Timestral
Su ottobre, con quasi tre anni di storico, l'errore medio in coperti al giorno è:
- "Come la settimana scorsa": 10,6
- "Media degli ultimi 4": 9,2
- Timestral 5M: 7,8
- Timestral 28M, 123M e 209M: 7,6
Circa il 17% in meno della regola migliore, senza addestrare niente. Su 88 coperti medi, vuol dire sbagliare di 7-8 persone invece di 9-10.
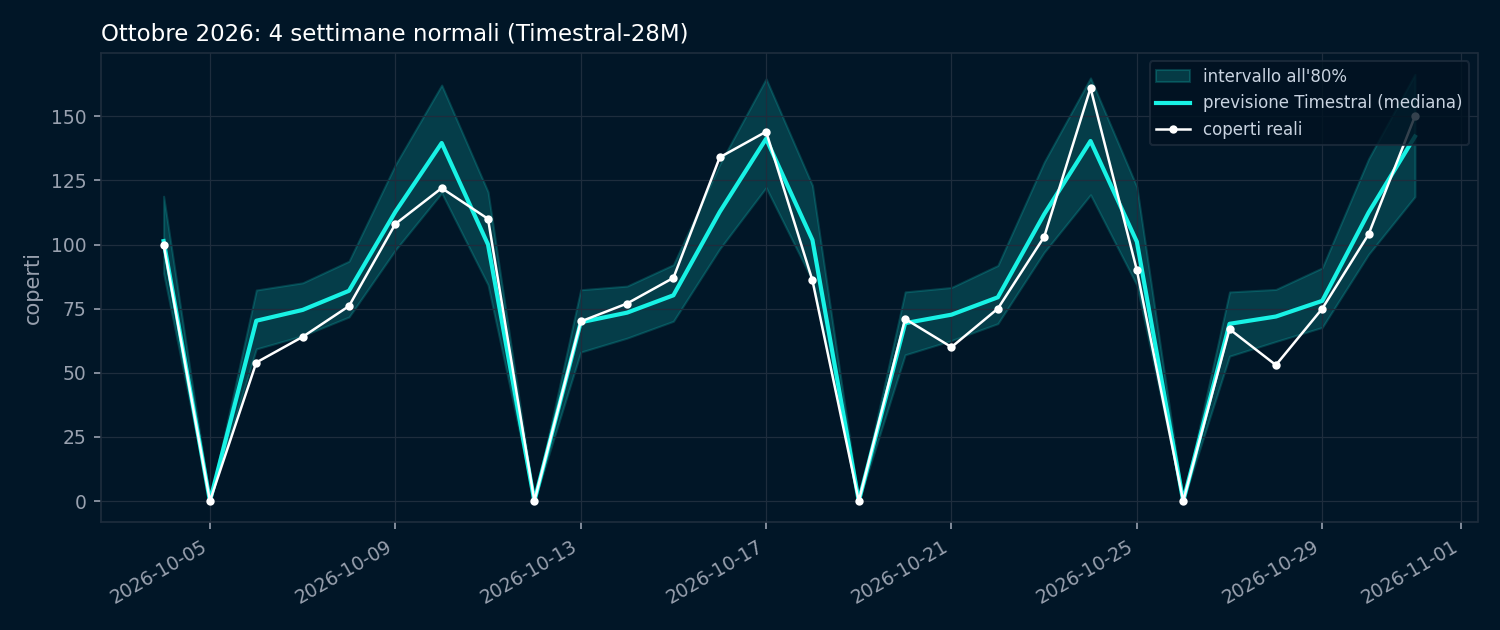
Ottobre 2026, Timestral-28M senza covariate (dataset con seme 42).
Due cose mi hanno colpito più dell'errore medio:
- Gli intervalli sono onesti. L'intervallo all'80% contiene il valore reale nell'81% dei giorni. È esattamente quello che deve fare, ed è l'informazione più utile per un ristoratore: non "farai 120 coperti", ma "preparati per un range tra 100 e 140".
- È velocissimo. Con i modelli piccoli una previsione di 4 settimane richiede tra 0,02 e 0,2 secondi su CPU; anche il più grande, il 209M, prevede 6 settimane in circa 0,13 secondi e si carica in un secondo.
E in un mese normale le taglie sono praticamente pari: dal 5M al 209M l'errore resta tra 7,6 e 7,8. Per un caso così, il modello più piccolo basta.
Risultato 2: con poco storico, vince la regola semplice
Stessa finestra di ottobre, ma Timestral vede solo le ultime 8 settimane:
- "Media degli ultimi 4": 9,2
- Timestral 28M con calendario: 9,8
- Timestral 28M: 10,2
- Timestral 5M: 13,4 (e molto variabile da un dataset all'altro: tra 8,5 e 20,2)
Con due mesi di dati la regola semplice è meglio, o almeno non peggio. Ha senso: in 8 settimane ci sono 8 sabati, e la media degli ultimi 4 sabati è già una buona stima. Il modello non ha abbastanza storia per fare meglio.
Per un locale appena aperto, Timestral non è la prima cosa da provare.
Risultato 3: agosto, e la sorpresa del calendario
Questo è il caso difficile. Dal 20 luglio al 31 agosto il ristorante perde quasi metà dei clienti, e le regole a occhio vanno in crisi, perché "come la settimana scorsa" non sa che sta arrivando agosto. Con tutto lo storico, e senza covariate:
- "Come la settimana scorsa": 35,7
- "Media degli ultimi 4": 35,8
- Timestral 28M: 23,8
- Timestral 123M: 24,2
- Timestral 209M: 12,8
Tutte le taglie fanno meglio delle regole, perché hanno visto l'agosto dell'anno prima nello storico e se ne ricordano. Ma qui, a differenza di ottobre, la taglia conta: il 209M sbaglia il 64% in meno delle regole a occhio, e quasi la metà del 28M. E il suo intervallo all'80% contiene il valore reale nell'86% dei giorni: resta onesto anche in un periodo anomalo, mentre quello del 28M si ferma al 52%.
Poi ho dato al modello il calendario: giorno della settimana, festivi e chiusure. E la previsione è peggiorata, per tutte le taglie.
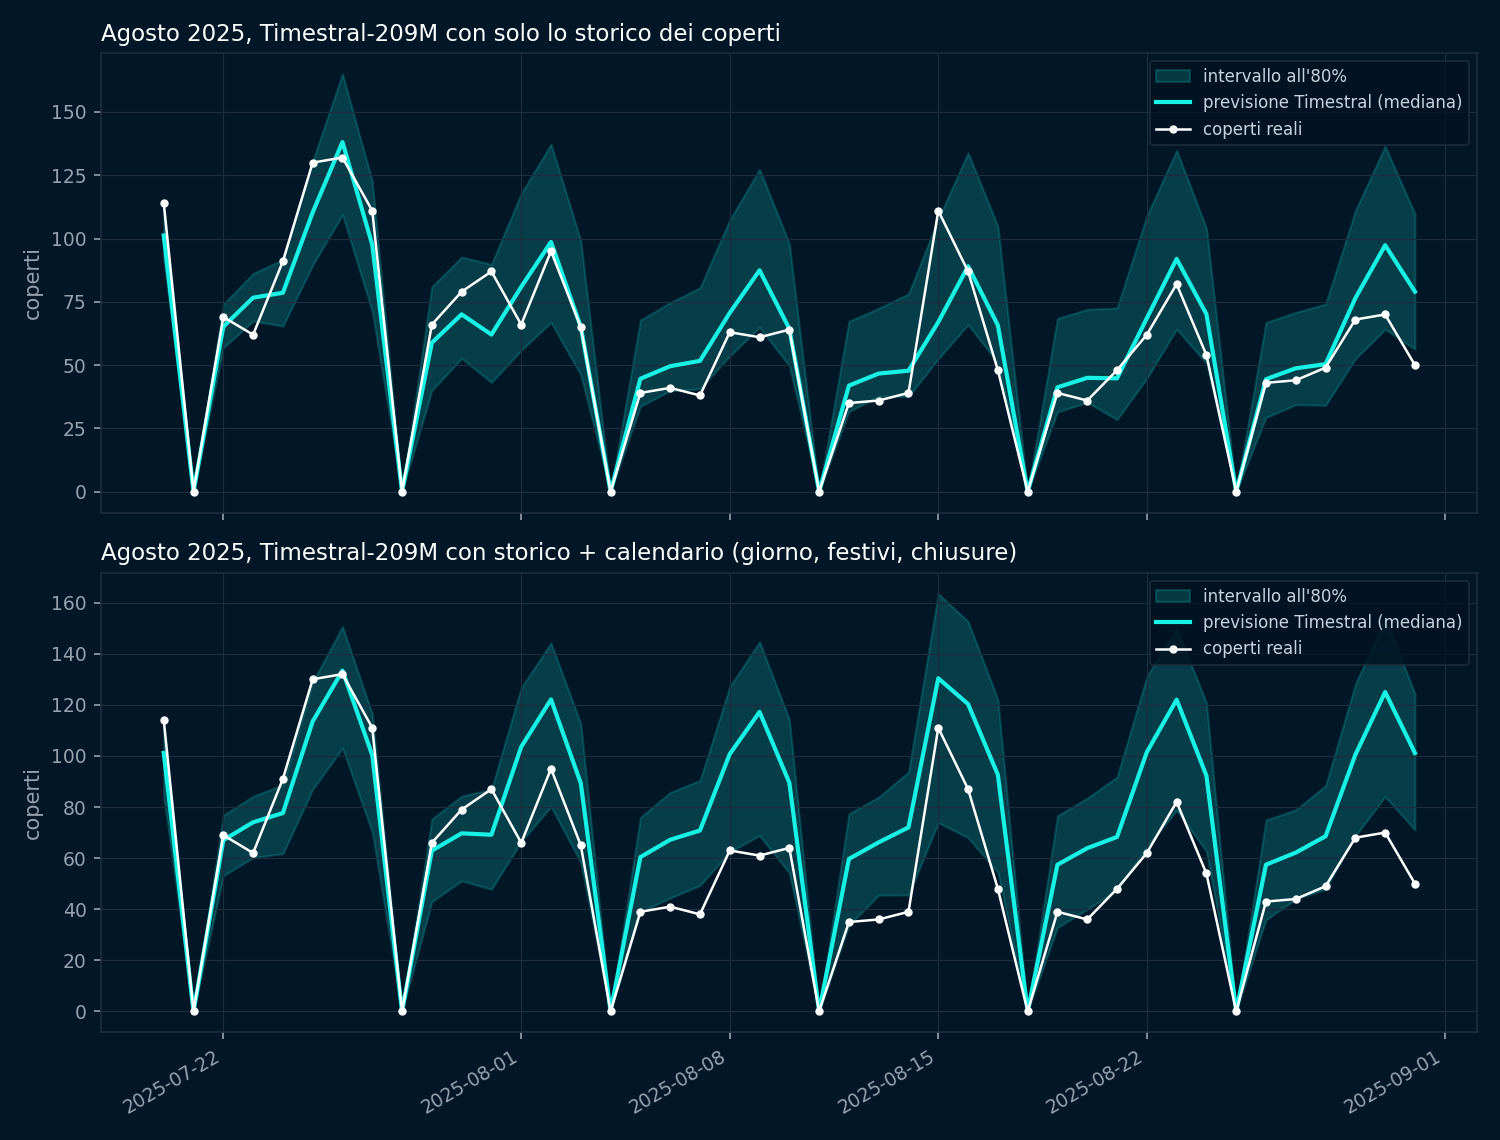
Agosto 2025, Timestral-209M (dataset con seme 42). In alto solo lo storico, in basso storico + calendario.
Con il calendario, la previsione (in basso) ignora il calo e torna a disegnare la "settimana tipo" di luglio. Per capire quale informazione fa danni, ho rifatto la prova aggiungendo una covariata alla volta. Errore medio ad agosto:
- 209M: solo storico 12,8 · con festivi e chiusure 16,2 · con il giorno della settimana 30,5 · con tutto 28,9
- 28M: solo storico 23,8 · con festivi e chiusure 29,2 · con il giorno della settimana 31,4 · con tutto 31,7
Il colpevole principale è il giorno della settimana: da solo, porta l'errore del 209M da 12,8 a 30,5, quasi come le regole a occhio. E rende il modello troppo sicuro di sé: con tutte le covariate, l'intervallo all'80% contiene il valore reale solo nel 36% dei giorni per il 209M, e nel 22% per il 28M. Sui modelli piccoli fanno danni anche festivi e chiusure, ma molto meno.
Perché succeda non lo so con certezza: l'esperimento mi dice quale covariata fa danni, non il meccanismo interno. La mia interpretazione è che il giorno della settimana offra al modello una scorciatoia ("sabato = tanti coperti") che gli fa pesare meno l'andamento dell'anno precedente. Il ritmo settimanale, del resto, il modello lo vede già benissimo nello storico, quindi quell'informazione non aggiunge niente.
La lezione pratica è chiara: più informazioni non vuol dire previsioni migliori. Ogni covariata va provata, sulle finestre difficili, prima di metterla in produzione.
E con solo 8 settimane di storico ad agosto? Sbagliano tutti allo stesso modo, tra 33 e 36 coperti. Nessun modello può prevedere un agosto che non ha mai visto.
Cosa significa per un ristorante
Se dovessi consigliare Timestral a un ristoratore, gli direi questo:
- Serve almeno un anno di storico, meglio due. È lì che il modello fa la differenza, soprattutto sui periodi stagionali.
- Per i periodi stagionali usa il modello più grande. Nei mesi normali le taglie si equivalgono, ad agosto il 209M fa la differenza. E su CPU costa comunque una frazione di secondo.
- Usa l'intervallo, non solo il numero. Per ordinare la merce deperibile, il limite basso evita gli sprechi; per i turni del personale, il limite alto evita di trovarsi scoperti. Decidere quale limite usare è un altro problema, ed è il tema del prossimo articolo della serie.
- Non dare per scontato che il calendario aiuti. Nel mio caso il giorno della settimana peggiorava le previsioni: prova con e senza, sulle settimane difficili.
- Può restare in casa. Gira su CPU in una frazione di secondo e la licenza permette l'uso on-premise: i dati di cassa non devono uscire dal locale.
I limiti di questa prova
Meglio dirli chiaramente:
- I dati sono simulati. Un ristorante vero ha eventi, partite, concerti, prenotazioni di gruppo, il cantiere davanti al locale. Le regole della mia simulazione sono pulite, e i numeri reali saranno peggiori per tutti i metodi.
- Un solo tipo di locale. Una pizzeria da asporto o un locale turistico hanno ritmi molto diversi.
- Non ho provato il meteo previsto come covariata futura, che è probabilmente la più utile in assoluto. Visto quello che succede con il calendario, sarebbe la prima cosa da verificare.
- Nessuna messa a punto. Ho usato il modello così com'è, ed è proprio il punto: volevo vedere cosa fa uno zero-shot.
Conclusione
Timestral fa quello che promette: senza addestramento, in una frazione di secondo e su un portatile, prevede i coperti meglio delle regole a occhio, con intervalli onesti. Nei periodi stagionali la differenza è ancora più grande, fino al 64% di errore in meno con il 209M, ma solo se ha abbastanza storia per ricordarseli.
Le due cose che mi porto via sono meno ovvie: con poco storico, la regola semplice resta imbattibile; e dare al modello più informazioni, nel mio caso il giorno della settimana, può renderlo più sicuro di sé e meno preciso allo stesso tempo.
Questo è il primo articolo di una serie sull'AI per la ristorazione. Nei prossimi:
- dalla previsione alla decisione: modelli decisionali come Jev e Rizzo Flow, per passare da "farò tra 100 e 140 coperti" a "chiama un cameriere in più";
- un VLM in sala: un modello che guarda i tavoli e segnala quelli da sparecchiare o quelli che aspettano da troppo.
Lo script che genera i dati e quello dell'esperimento sono pronti: se vuoi rifare la prova sui coperti veri del tuo locale, scrivimi.